Tableau de bord de coaching sportif : séparation stricte données/affichage et standardisation d'API

Scores de cette page :
EcoIndex A
SEO 100%
Accessibilité 100%
Performance 100%
Bonnes Pratiques 100%
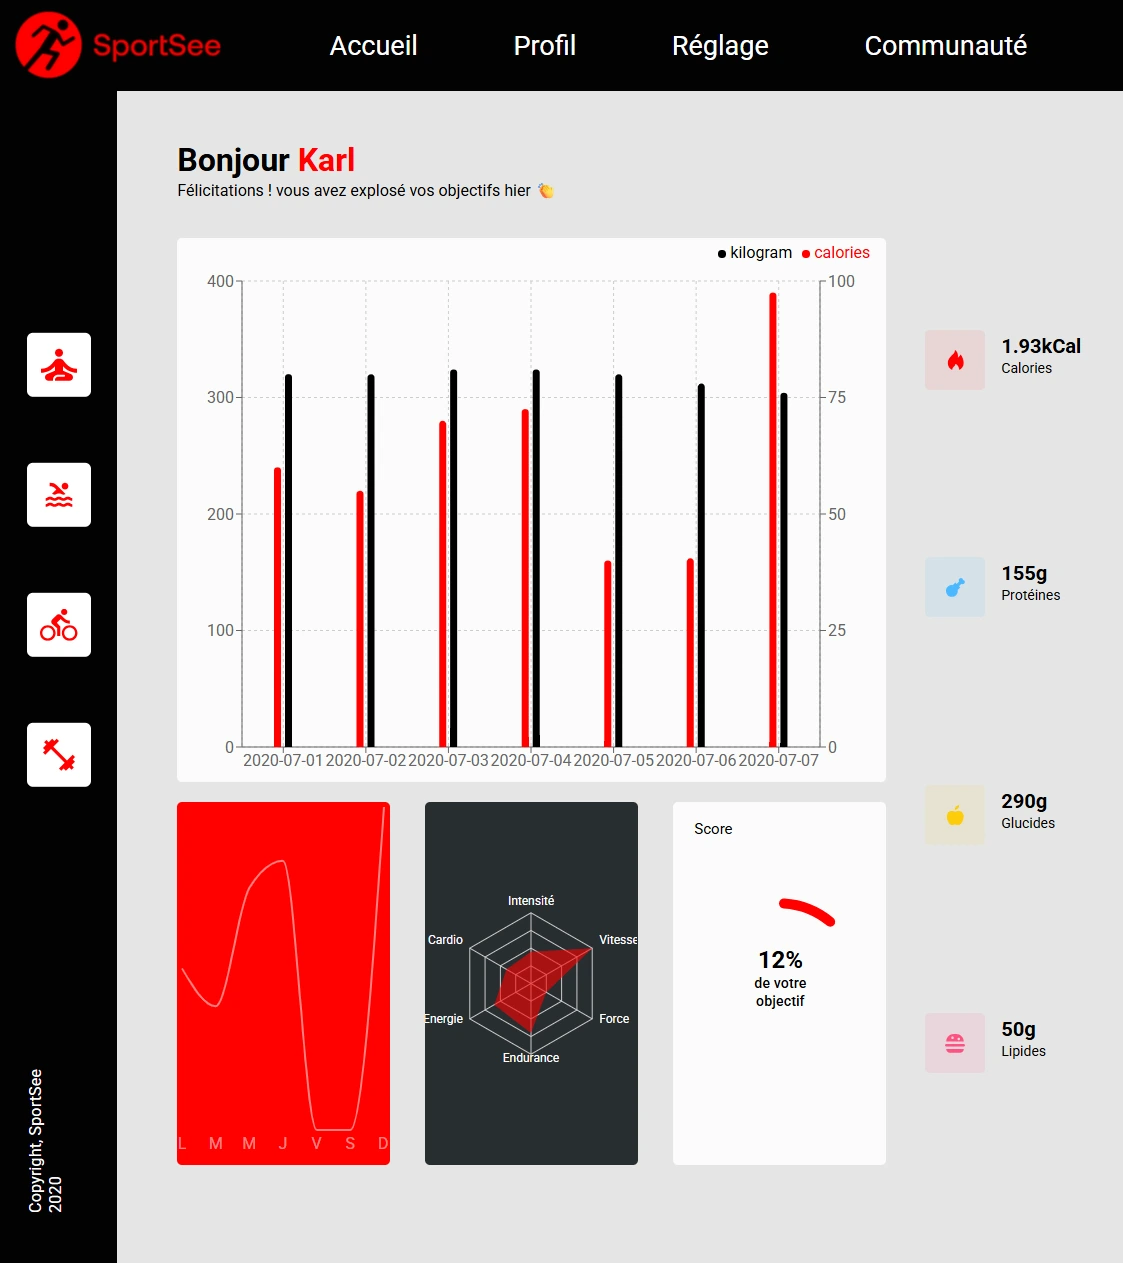
Projet de formation (OpenClassrooms) : développement de la page profil de SportSee, plateforme de coaching sportif — quatre graphiques d'activité (Recharts) alimentés par un backend Node.js, avec un service de récupération de données isolé des composants, une couche de standardisation pour absorber les variations de schéma entre utilisateurs, et une documentation JSDoc générée automatiquement.
Contexte : une seule page, mais un vrai cahier des charges
Projet réalisé en formation (parcours Développeur Web, OpenClassrooms), avec une mise en situation professionnelle complète : un Product Owner qui transmet la maquette Figma et les user stories à réaliser, un lead développeur qui précise ensuite les contraintes techniques par email. Le sprint ne portait que sur une seule page — le tableau de bord de profil d'un utilisateur de la plateforme de coaching sportif SportSee — les autres pages du site (réglages, communauté) devant rester de simples coquilles vides à ce stade, conformément au découpage en sprints prévu par le client.
Stack technique
React 17 avec Create React App, react-router-dom pour la navigation entre les quatre pages (Accueil, Profil, Réglage, Communauté), Axios pour les appels HTTP vers un backend Node.js fourni séparément, Recharts pour les graphiques, Sass pour le style, PropTypes pour la validation de type des props, JSDoc pour la documentation générée automatiquement.
Construire la structure avant le contenu
Le développement n'a pas commencé par la page principale, mais par le squelette du site : d'abord le système de navigation entre les pages (React Router), puis les éléments d'interface communs à toutes les pages — la navigation horizontale du haut, la barre latérale de gauche, le logo cliquable qui ramène à l'accueil — conçus comme des blocs réutilisables dès le départ. Les pages non prioritaires pour ce sprint (réglages, communauté, page d'erreur) ont ensuite été posées comme de simples coquilles reprenant ces mêmes éléments communs, avec un texte d'attente à la place du contenu. Ce n'est qu'une fois cette ossature posée que le vrai travail sur la page de profil a commencé.
Le principal défi : comprendre en profondeur le cycle de chargement des données
La difficulté la plus formatrice du projet a été de bien maîtriser deux mécanismes React qui travaillent ensemble pour charger des données depuis un serveur distant : l'un qui mémorise une information (par exemple, « les données sont-elles arrivées ? »), l'autre qui déclenche une action à un moment précis (par exemple, « dès que l'identifiant de l'utilisateur change, va rechercher ses nouvelles données »). Pour bien comprendre ce que ces mécanismes faisaient concrètement en coulisses, il a fallu revenir à une façon plus ancienne et plus explicite d'écrire des composants React, plus verbeuse mais plus facile à décortiquer, avant de revenir à l'écriture moderne utilisée dans le projet final. Recharts, la bibliothèque de graphiques imposée par le brief, était elle aussi découverte pour l'occasion — chaque type de graphique a demandé un temps de consultation de sa documentation avant intégration.
Un service de données isolé des composants
Consigne explicite du lead dev : aucun appel HTTP directement dans un composant React. Toute la récupération de données passe par un service dédié (Axios) exposant une fonction par endpoint du backend — données principales, activité, moyennes de sessions, performance. Les composants d'affichage ne connaissent jamais l'existence de l'API, ils reçoivent des données déjà prêtes en props. Ce découplage a un avantage concret : pour tester l'application avec des données simulées plutôt qu'un vrai serveur, il suffit de remplacer l'adresse ciblée par ce service, sans toucher au reste de l'application.
Standardisation des données
Le schéma de données renvoyé par l'API varie légèrement selon l'utilisateur — point signalé explicitement par le lead dev dans son brief. Une couche de classes JavaScript dédiées (une par type de donnée : principales, activité, moyennes de sessions, performance) reformate systématiquement la réponse brute en un objet aux propriétés prévisibles avant qu'elle n'atteigne les composants. Cette standardisation découple la structure interne de l'API du reste de l'application : les composants d'affichage travaillent toujours sur le même format, quelle que soit la forme exacte de la réponse serveur.
Quatre graphiques avec Recharts
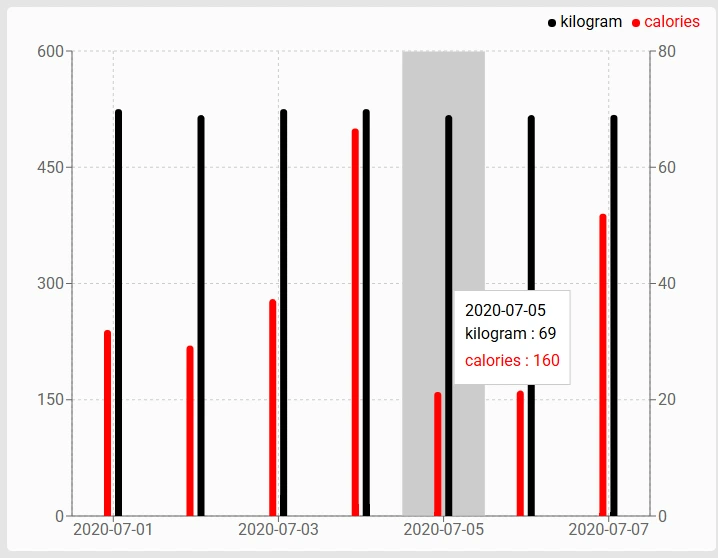
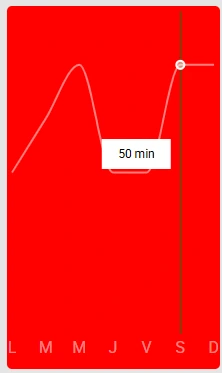
Recharts a été choisi plutôt que D3.js, sur la recommandation explicite du lead dev pour sa prise en main plus rapide sur ce sprint. Quatre graphiques composent le tableau de bord : activité quotidienne en barres doubles (kilogrammes et calories brûlées par jour, sur deux axes verticaux distincts pour gérer des échelles très différentes, avec une infobulle affichant les deux valeurs exactes au survol d'une date), durée de session par jour en courbe (avec une infobulle affichant la durée exacte en minutes au survol), type d'activité en radar à six axes (cardio, énergie, endurance, force, vitesse, intensité), et score du jour en anneau de progression avec le pourcentage affiché au centre. Chaque graphique est écrit comme un composant à part entière, recevant ses données déjà formatées en props — la même « brique » de code peut donc être réutilisée telle quelle pour n'importe quel utilisateur, sans rien réécrire.
Un tableau de bord qui s'affiche progressivement, jamais à moitié vide
Les quatre jeux de données du tableau de bord (informations principales, activité, moyennes de sessions, performance) sont demandés en parallèle au chargement de la page, chacun gardant en mémoire son propre état : la donnée elle-même, le fait qu'elle soit encore en cours de chargement, ou qu'une erreur soit survenue. Tant que ces quatre réponses ne sont pas toutes arrivées, un écran d'attente s'affiche à la place du tableau de bord — pour éviter d'afficher une page à moitié construite, avec certains graphiques présents et d'autres non. Le prénom affiché dans le message de bienvenue (« Bonjour, Karl », « Bonjour, Cécilia »...) provient lui aussi de ces données, et change automatiquement selon l'identifiant d'utilisateur présent dans l'adresse de la page.
Documentation générée automatiquement
Chaque fonction et chaque classe du projet est commentée selon un format standardisé (JSDoc) qui précise ce qu'elle fait, ce qu'elle reçoit en entrée et ce qu'elle renvoie. Une commande dédiée transforme ensuite automatiquement l'ensemble de ces commentaires en un petit site de documentation consultable localement, listant toutes les classes de données et tous les composants du projet avec leurs paramètres — pour qu'une autre personne puisse reprendre le projet sans avoir à déchiffrer le code ligne par ligne. Un fichier README accompagne également le projet sur GitHub, avec les instructions d'installation et de lancement du backend et du frontend.
Une nomenclature pensée pour se passer de commentaires
Au-delà de la documentation générée, les noms de fichiers, de fonctions et de variables ont été choisis pour être immédiatement compréhensibles sans avoir besoin d'explication supplémentaire — par exemple, le graphique de l'activité quotidienne s'appelle simplement « DailyActivityGraph », la fonction qui va chercher les données principales s'appelle « getMainData ». Cette discipline de nommage réduit le besoin de commentaires disséminés dans le code, tout en le gardant lisible pour quelqu'un qui le découvre.
Validation de type avec PropTypes
Chaque composant valide le type des données qu'il reçoit via PropTypes, sur l'ensemble du projet. Si jamais une donnée transmise à un graphique n'est pas du format attendu, une erreur explicite s'affiche pendant le développement plutôt qu'un plantage silencieux ou un rendu incohérent une fois l'application en ligne.
Desktop uniquement, une contrainte assumée pour ce sprint
Mise en page générale pilotée par une grille CSS nommée (zones logo, navigation, barre latérale, contenu), partagée par toutes les pages y compris celles encore vides. Aucune adaptation mobile n'a été prévue à ce stade, conformément à la demande explicite du Product Owner de se concentrer uniquement sur le confort d'usage desktop pour ce sprint — le responsive étant planifié pour une itération ultérieure.